Article
Un mois de confiance, trois mois de réalité : ce que vivent les équipes qui testent seules l'IA générative sur leurs AO
« On sait déjà faire ça avec Claude ou ChatGPT. » La phrase revient souvent en rendez-vous, et elle est souvent vraie le premier mois. Ce que vivent les équipes qui poussent le sujet au-delà, et pourquoi l'enjeu n'a jamais été l'accès à un modèle de langage.
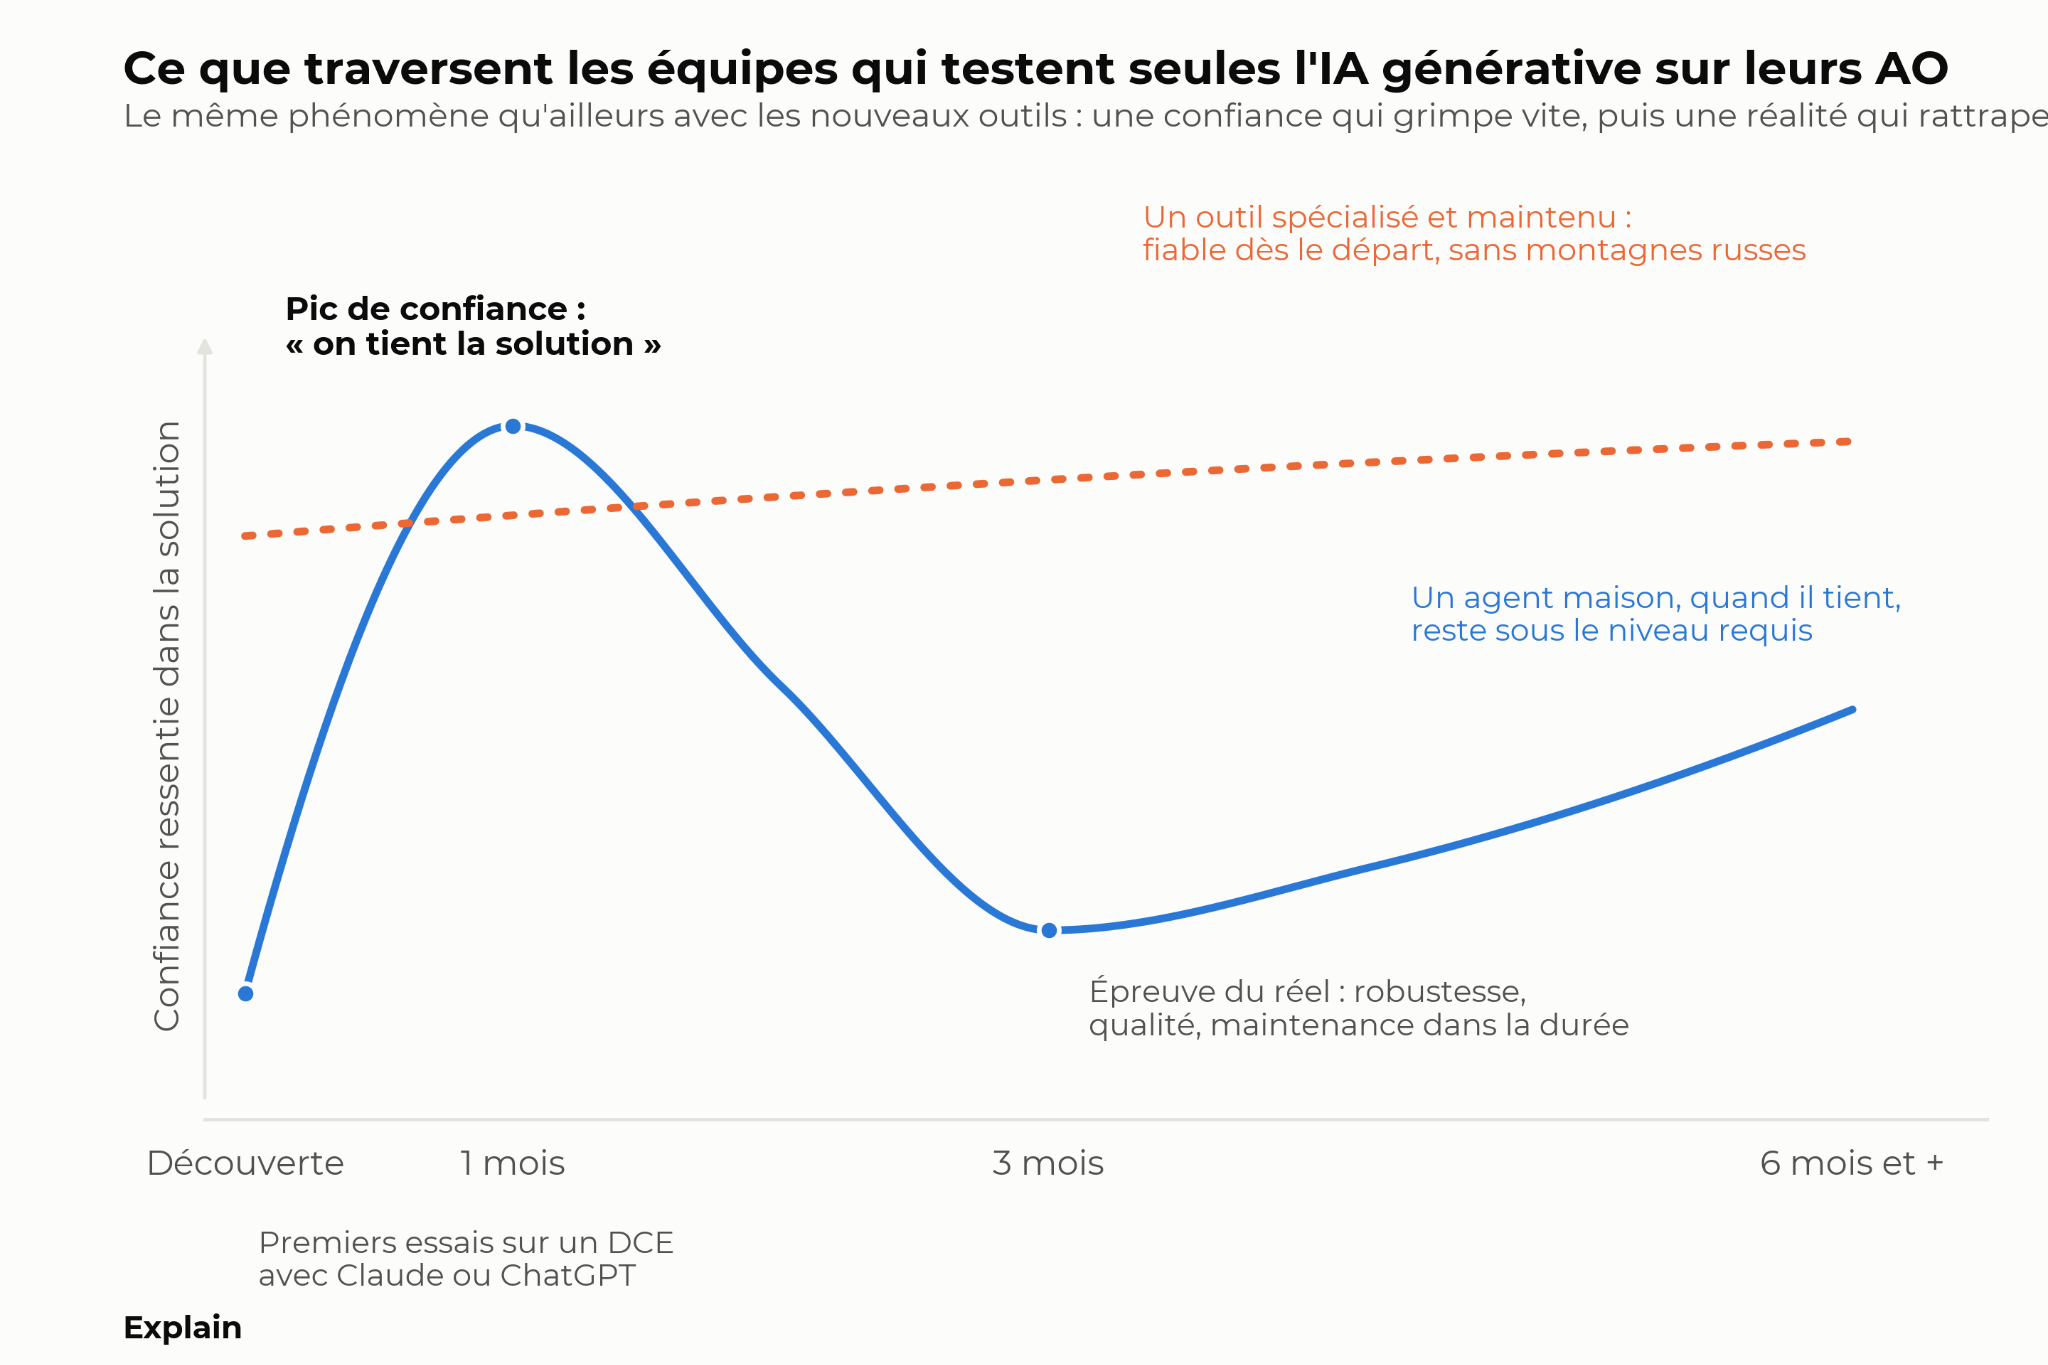
En rendez-vous, il y a un moment qui revient souvent. On présente Explain à un directeur d'agence, un responsable de cellule AO, un chargé d'études qui répond à des marchés publics depuis des années. Et à un moment de l'échange, la même phrase arrive : « On sait déjà faire ça avec Claude ou ChatGPT. »
Ce n'est pas un mensonge, ni de la mauvaise foi. C'est même souvent vrai, sur un plan précis : coller un extrait de cahier des charges dans une IA généraliste et en sortir un plan de mémoire technique correct, n'importe quel chargé d'études un peu curieux sait le faire aujourd'hui. Le problème n'est pas là mais dans ce qui se passe dans les mois qui suivent.
Le mois où tout semble possible
Le scénario est presque toujours le même : la personne teste, obtient un résultat étonnamment bon sur un dossier, et en l'espace d'un mois se sent capable d'aller beaucoup plus loin. Elle a le sentiment d'avoir trouvé une solution que ni sa direction ni ses concurrents n'ont encore identifiée. L'ambition grandit vite : construire des agents maison capables de surveiller les publications d'AO, d'analyser automatiquement les DCE, d'aider sur la stratégie de réponse, puis de rédiger et de relire le dossier.
Ce mouvement n'est pas propre aux appels d'offres, ni même à l'IA. Gartner l'appelle le passage du « pic des attentes exagérées » au « creux des désillusions », et plaçait justement l'IA générative dans ce creux dans son Hype Cycle 2025. Une étude du MIT publiée en août 2025, menée sur 300 déploiements en entreprise, va dans le même sens : 95% des projets d'IA générative ne produisent aucun impact mesurable sur les résultats, alors même que l'usage individuel d'outils comme ChatGPT ou Claude explose, parce qu'il est immédiat et flexible. La confiance grimpe très vite, portée par les premiers résultats individuels. Elle redescend ensuite à peu près aussi vite qu'elle est montée, dès qu'il s'agit d'en faire un processus fiable.
Ce que révèle le troisième mois
Chez les équipes qui poussent vraiment le sujet, au-delà du premier mois, trois difficultés reviennent presque systématiquement, quel que soit le type de marché sur lequel elles travaillent.
La première est la difficulté à construire des agents robustes seuls. Un prompt qui fonctionne une fois sur un dossier ne fonctionne pas nécessairement sur le suivant. Rendre un agent fiable demande de structurer des données, d'anticiper les cas particuliers, de tester sur des dizaines de dossiers réels, de corriger ce qui échoue. C'est un travail d'ingénierie dans la durée, pas un réglage de week-end, même pour des équipes qui ont de vraies compétences techniques.
La deuxième est la difficulté à atteindre un niveau de qualité satisfaisant, et à le garder constant. Un agent qui produit un bon résultat un jour peut produire un résultat médiocre le lendemain, sur un dossier comparable, sans qu'on comprenne toujours pourquoi. Cette instabilité rend impossible toute industrialisation : on ne peut pas construire un processus commercial fiable sur un outil dont la qualité varie d'un dossier à l'autre.
La troisième est la difficulté à maintenir l'agent dans le temps. Les modèles évoluent, les formats de DCE aussi, les besoins de l'équipe changent. Sans un travail de maintenance et de R&D continu, la qualité se dégrade en quelques semaines. Le coût caché est là : le temps qui devait être libéré pour répondre à plus d'AO, ou pour passer plus de temps avec les prospects, sert en réalité à entretenir l'outil, pas à vendre davantage.
Ce que ça change dans la façon de vendre
Sur les appels d'offres, la chute qui suit le pic de confiance a un coût direct : des dossiers moins bien préparés, du temps commercial perdu, parfois des marchés non déposés dans les délais.
Ce que nos clients dans l'eau, les travaux publics, le transport, l'énergie ou les prestations intellectuelles nous disent, une fois passés par cette phase, c'est que le sujet n'a jamais été l'accès à un modèle de langage. Tout le monde y a accès, Claude et ChatGPT compris, gratuitement ou presque. Le sujet, c'est ce qui se trouve entre le modèle et le mémoire déposé : la connaissance du vocabulaire sectoriel, la structure d'un CCTP, la logique d'une grille de notation, des milliers de DCE et de mémoires déjà analysés pour calibrer chaque réponse. C'est ce travail-là qui prend du temps à construire, qui doit être maintenu en continu, et qui ne se fait pas à côté d'un métier commercial ou d'une cellule AO déjà pleine.
Il y a enfin une question plus simple à se poser. Vos équipes ont sans doute les compétences pour construire, à force de temps, quelque chose qui tienne la route. Mais leur métier, c'est de gagner des marchés, pas de concevoir des agents IA. Le nôtre, si : c'est la seule chose qu'on fait, en échangeant chaque semaine avec des cellules AO dans tous les secteurs, partout en France. La question n'est pas de savoir si vos équipes pourraient y arriver un jour. C'est de savoir qui a le plus de chances d'y arriver en premier, et d'en garder le niveau dans la durée.
Sources : Gartner, Hype Cycle for Generative AI, 2025 (juillet 2025) ; MIT NANDA, The GenAI Divide: State of AI in Business 2025 (août 2025) ; TechCrunch et Fortune, reportages sur le dépassement du budget IA d'Uber (mai-juin 2026).